Flux · Documents & données
Un parcours de traitement documentaire associant extraction assistée par LLM, structuration des données et règles de validation. Les cas ambigus sont orientés vers une revue plutôt que traités silencieusement.
Le besoin
Éviter la ressaisie manuelle tout en conservant un contrôle sur la qualité des informations extraites.
Le système proposé
Conception d’un pipeline de démonstration : extraction, normalisation, contrôle de champs et file de revue.
Le parcours utilisateur
Visualiser le passage d’un document à un objet structuré, puis repérer les champs à vérifier.
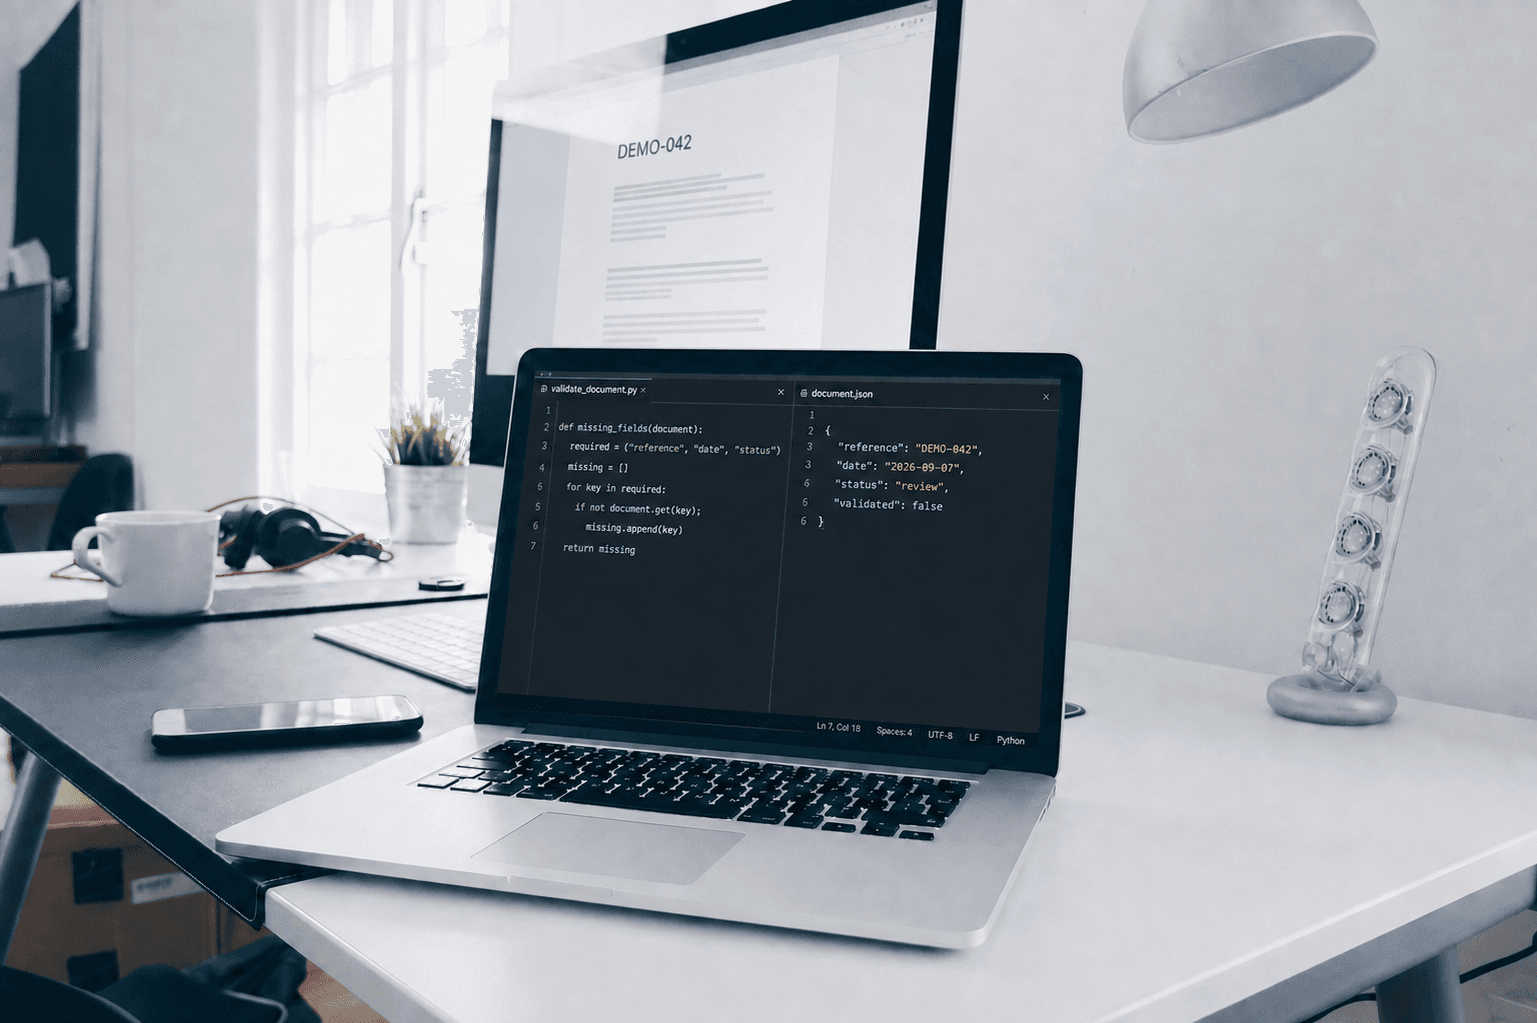
Photo retouchée · Christopher Gower · Contenu d’écran adapté pour illustrer le domaine de travail.
Démonstration interactive
Suivre le fonctionnement
Le scénario
Document DEMO-042 · référence, date et informations structurées.
Recevoir
Un document fictif entre dans le pipeline.
Extraire
Les champs utiles sont structurés dans un objet JSON.
Valider
Les règles contrôlent les champs obligatoires.
Orienter
Le document est prêt à traiter ou dirigé vers une revue.
Un extrait de code · Python
Exemple de logique de contrôle. Ce code illustre une règle ; le parcours ci-dessus reste une simulation.
def missing_fields(document):
    required = ("reference", "date", "status")
    return [key for key in required
            if not document.get(key)]